deepseek-visionary는 MCP 에이전트에 OCR 및 시각적 맥락을 추가합니다.
Xlight의 deepseek-visionary는 텍스트 전용 AI 에이전트에 시각적 입력을 제공하는 MCP 서버 및 플러그인으로, 에이전트 워크플로우 내에서 이미지 기반 텍스트 로컬라이제이션 및 OCR을 가능하게 합니다. 이 도구는 DeepSeek 비전-언어 모델을 모델 컨텍스트 프로토콜 호스트에 연결하고, 내장된 텍스트를 추출하며, 다운스트림 LLM 소비를 위한 구조화된 설명을 생성합니다. 주요 기능으로는 JSON/마크다운 이미지 설명, 하이브리드 OCR 및 비전-언어 분석, 다중 호스트 호환성이 포함되어 있으며, 이는 시각적 처리를 MCP 파이프라인에 통합하는 개발자 및 연구자를 목표로 합니다.
실제로 어떤 작업에 사용할 수 있나요?
Visionary는 시각 자산을 기계가 읽을 수 있는 텍스트와 설명 메타데이터로 변환하여 에이전트가 이미지 콘텐츠에 대해 작업할 수 있도록 합니다. UI 텍스트 로컬라이제이션, 문서 필사 및 언어 모델을 위한 이미지 설명 생성과 같은 작업을 위해 구축되었습니다. 구체적인 출력에는 OCR 전사 및 LLM 프롬프트 또는 자동화 스크립트에 직접 연결되는 구조화된 JSON 또는 마크다운 설명이 포함됩니다. 일반적인 워크플로우는 추출된 텍스트를 로컬라이제이션 파이프라인 또는 주석 도구와 쌍으로 사용합니다.
로컬라이제이션 및 OCR의 출력 정확도는 얼마나 되나요?
이 프로젝트는 높은 정확도의 광학 문자 인식을 광고하며, 그 OCR을 비전-언어 모델 설명과 결합하여 맥락을 추가합니다. 정확도는 선택한 백엔드 및 모델에 따라 다릅니다, 서버는 자동화된 브라우저 경로를 통해 접근할 수 있는 여러 비전 제공자 및 웹 네이티브 모델을 지원합니다. 구조화된 출력은 다운스트림 처리를 위해 깨끗한 JSON 또는 마크다운을 제공하여 파싱 오류를 줄이는 것을 목표로 합니다.
기술 설정이 필요한가요? 개발자 워크플로우에 어떻게 적합하나요?
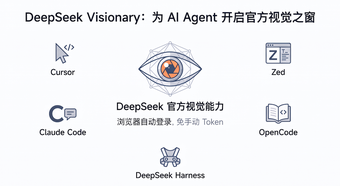
Visionary는 Node.js 서버 구성 요소로 실행되며 MCP 호환 호스트와 통합되므로 설정은 개발 환경을 기대합니다. 지원되는 호스트에는 Claude Desktop, Zed, Cursor 및 네이티브 플러그인으로 사용할 때 DeepSeek Harness가 포함됩니다. 웹 네이티브 비전 접근을 위한 자동 세션 관리 및 독립 실행형 MCP 서버 모드는 엔지니어가 호스트 코드를 다시 작성하지 않고도 기존 에이전트 파이프라인에 구성 요소를 포함할 수 있도록 합니다.
팀이 백엔드 및 데이터 처리에 대해 고려해야 할 사항은 무엇인가요?
이 프로젝트는 여러 백엔드 옵션을 제공합니다: 구성은 표준 API 키 없이 웹 네이티브 비전 모델에 접근하기 위해 visionary-server CLI를 사용할 수 있거나 공급업체 서비스에 대한 공식 API 자격 증명에 연결될 수 있습니다. Xlight는 또한 기본 제공자가 접근할 수 없는 경우 이미지 처리를 계속할 수 있도록 다중 호스트 폴백을 구현합니다. 팀은 커넥터 관리 계획을 세우고 목표 콘텐츠 유형에 대해 선택한 백엔드를 테스트해야 합니다.
검토 가능한 커뮤니티 지원 도구를 중요시하는 개발자 팀에 적합
이 프로젝트는 GitHub에 호스팅되며 MCP 및 DeepSeek Harness 커뮤니티 목록에서 자주 인용되므로 커넥터를 조정하거나 처리 코드를 검토할 계획인 팀에 적합합니다. 실용적인 팁으로는 생성된 텍스트를 사용하는 모든 현지화 파이프라인에 인간 검토를 포함하는 것입니다. 커뮤니티 가시성이 있는 MCP 네이티브 비주얼 브리지가 필요한 개발자에게 이 프로젝트는 실용적인 선택입니다.